2.3. 卷积神经网络(CNN)实战(基础):猫狗照片二分类
本文承接 2.2. 卷积神经网络(CNN)模型理论(进阶):图像填充、LeNet、AlexNet,没看过的建议先看前文。
2.3.1. 准备工作
请在终端输入指令以下载和安装:
pip install keras tensorflow
我们的任务是对猫狗进行二分类,会使用到猫狗的照片,这里我们使用Kaggle数据集,各位可以到 kaggle数据集、mnist数据集、imdb数据集分享 这个帖子中找到下载链接,下载好后要先解压。在train文件夹中,创建cat和dog两个文件夹,把猫的照片放到cat中,把狗的照片放到dog中,最后的路径应该长这样:
.\train
	\train
		\dog
			\dog.0.jpg
			\dog.1.jpg
			\dog.2.jpg
			...
		\cat
			\cat.0.jpg
			\cat.1.jpg
			\cat.2.jpg
			...
把train文件夹直接拖入Python项目文件夹中即可。
2.3.2. 整体架构
以下是我们的卷积神经网络整体模型:
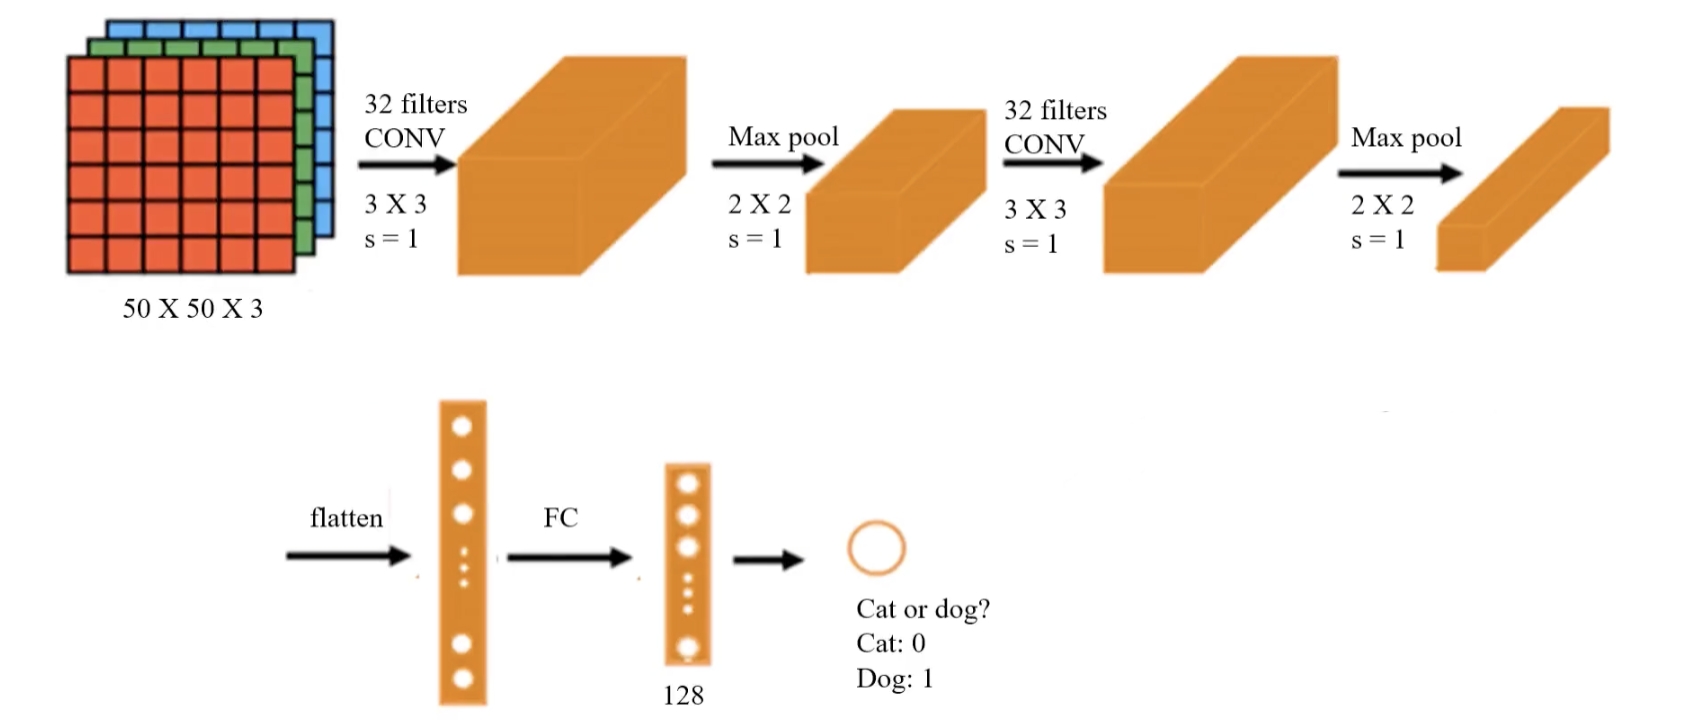
- 输入层:
- 输入尺寸为 50 × 50 × 3,表示输入图像为 50×50 像素,并具有 3 个通道(RGB 彩色图像)。
- 第一层卷积(Conv Layer 1):
- 使用 32 个 3×3 卷积核,步长 (stride) = 1。
- 这一层提取低级特征,如边缘、纹理等。
- 卷积层采用ReLU函数
- 第一层池化(Max Pooling 1):
- 池化核大小 2×2,步长 = 2(Keras 默认:步长等于
pool_size)。 - 通过最大池化减少特征图的尺寸,提高计算效率,并增强特征的鲁棒性。
- 第二层卷积(Conv Layer 2):
- 再次使用 32 个 3×3 卷积核,步长 = 1。
- 继续提取更高级的特征,如轮廓、形状等。
- 卷积层采用ReLU函数
- 第二层池化(Max Pooling 2):
- 池化核大小 2×2,步长 = 2。
- 进一步降低特征图的尺寸,减少计算量。
- Flatten 层:
- 经过两次卷积和池化后,特征图被展平成一维向量,以便输入到全连接层。
- 全连接层(Fully Connected, FC):
- 经过一个 128 维的全连接层,用于学习最终的分类决策。
- 输出层:
- 最终输出是一个 单神经元,表示二分类问题(猫或狗)。
- 输出 0 表示猫,输出 1 表示狗。
2.3.3. 敲代码
Step 1: 加载图片与预处理
# 图片加载与预处理
from keras.preprocessing.image import ImageDataGenerator

train_datagen = ImageDataGenerator(rescale=1./255)
training_set = train_datagen.flow_from_directory('.\\train\\train',
                                                 target_size=(50, 50),
                                                 batch_size=128,
                                                 class_mode='binary')
-
ImageDataGenerator是一个用于图片数据增强和预处理的工具,它能够通过一系列的数据变换(如旋转、平移、缩放等)生成更丰富的训练数据,从而提高深度学习模型的泛化能力。 -
train_datagen是一个ImageDataGenerator的实例:rescale=1./255是对图片像素值进行缩放处理。原始图片的像素值通常在范围[0, 255]之间。通过设置这个参数,将像素值归一化到[0, 1]区间以便于更快收敛和更稳定的训练。ImageDataGenerator的参数不止这些,还可以进行缩放、平移、旋转等…
-
通过调用
flow_from_directory()方法,从指定的目录中加载图片数据并准备训练数据集:target_size参数指定图片在加载时的目标尺寸。这个参数会将所有图片调整为一致的大小(在这里是 50x50 像素)。batch_size参数指定每次从生成器中加载的图片批量大小:在深度学习中,训练数据通常会分成若干批次 (batch),这个参数定义了每一批次中包含的图片数量。在这里,batch_size=128表示生成器每次会生成 128 张图片数据以及对应的标签。较大的batch_size通常意味着更高的训练效率。但是如果你的显存太小,你也可以适当减小(32是一个很不错的配置),但会导致收敛不稳定的问题。class_mode参数设定为'binary',表示这是一个二分类问题,生成的标签会是二值化的(即 0 或 1)。如果设定为'categorical': 用于多分类问题,标签会使用one-hot编码,例如[1, 0, 0]表示属于第一类。如果设定为'sparse': 类似于'categorical',但标签是整数值,而不是 one-hot 编码,比如0、1、2。如果设定为None: 表示不返回标签,通常用于无监督学习或者预测(Inference)阶段。
注意,上面的路径写法是Windows下的。如果你在MacOS/Linux,请使用./train/train。
Step 2: 建立CNN模型
根据上图的架构我们来建立CNN模型:
# 建立模型
from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D, Flatten, Dense

model = Sequential()
# 卷积层
model.add(Conv2D(32, (3,3), input_shape=(50,50,3), activation='relu'))
# 池化层
model.add(MaxPooling2D(pool_size=(2,2)))
卷积层 (Conv2D) 的参数说明:
32(filters):- 表示这一层使用了 32 个卷积核(filter)。
- 每个卷积核会提取不同的特征,因此提取的特征图数量与卷积核的数量相同。最终输出为 32 个特征图。
(3, 3):- 指定卷积核的大小为 3x3 像素(通常取小值,如
(3, 3)或(5, 5))。 - 卷积核会在输入图片上滑动,提取局部特征。
- 指定卷积核的大小为 3x3 像素(通常取小值,如
input_shape=(50,50,3):- 表示输入数据的形状:
50x50是图片的分辨率(宽、高)。3是通道数,通常图片有 3 个颜色通道(RGB)。这是 CNN 的输入要求,你在数据预处理时必须确保图片数据符合该形状。
- 表示输入数据的形状:
activation='relu':激活函数使用了 ReLU(Rectified Linear Unit),它将负值变为 0,而正值保持不变。
池化层 (MaxPooling2D) 的参数说明:
pool_size=(2,2):- 指定池化操作的窗口大小为 2x2 像素。
- 具体操作:在每个 2x2 的窗口中,保留最大值(即 Max Pooling),丢弃其他值。
- 池化会将图片的宽和高各缩小一半。在 valid 填充下,第一层卷积输出大小是
48x48,经过池化后就变成24x24。
到目前为止只写到了第一个卷积+池化层,我们继续写第二个卷积+池化层:
# 第二个卷积+池化层
model.add(Conv2D(32, (3,3), activation='relu'))
model.add(MaxPooling2D(pool_size=(2,2)))
- 这里的
Conv2D不需要input_shape参数是因为代码会自己推断出上一层的输出的是什么大小
至此我们对图像的特征提取操作就完成了,接下来我们把特征展开到一维以供MLP模型接收:
# flatten层
model.add(Flatten())
然后我们来写MLP模型的架构(两层全连接,隐藏层有128个神经元,输出层就1个神经元用于二分类):
# 全连接层
model.add(Dense(units=128, activation='relu'))
model.add(Dense(units=1, activation='sigmoid'))
Step 3: 训练模型
接下来的操作和单使用MLP模型时的操作一样,进行训练核心参数配置:
# 配置训练
model.compile(optimizer='adam', loss='binary_crossentropy', metrics=['accuracy'])

# 查看结构
model.summary()
-
compile是 Keras 模型的方法,用于在训练模型之前配置模型的学习过程,它的主要参数有:- 损失函数(
loss):定义模型训练时计算误差的方法。 - 优化器(
optimizer):决定模型的参数(如权重和偏置)如何更新,以最小化损失函数。 - 评估指标(
metrics):决定用于评估模型性能的指标,这些指标不会影响模型训练,只用于衡量效果。
- 损失函数(
-
loss='binary_crossentropy':binary_crossentropy(二元交叉熵)是二分类任务中常用的损失函数 -
optimizer='adam':adam(Adaptive Moment Estimation)是一种自适应学习率优化算法,是深度学习中最常用的优化器之一 -
metrics=['accuracy']:指定模型在训练和评估时用准确率来衡量性能
输出:
Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ conv2d (Conv2D)                 │ (None, 48, 48, 32)     │           896 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d (MaxPooling2D)    │ (None, 24, 24, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ conv2d_1 (Conv2D)               │ (None, 22, 22, 32)     │         9,248 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ max_pooling2d_1 (MaxPooling2D)  │ (None, 11, 11, 32)     │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ flatten (Flatten)               │ (None, 3872)           │             0 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense (Dense)                   │ (None, 128)            │       495,744 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 1)              │           129 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 506,017 (1.93 MB)
 Trainable params: 506,017 (1.93 MB)
 Non-trainable params: 0 (0.00 B)
接着把数据喂给模型即可:
# 训练模型
model.fit(training_set, epochs=25)
epochs确定模型的迭代次数
Step 4: 评估模型
我们来看看它对训练数据的预测准确率:
# 计算模型预测准确率
accuracy_train = model.evaluate(x=training_set)
print("\nAccuracy on training set: ", accuracy_train[1])
输出:
Accuracy on training set: 0.9990400075912476
可以看到正确率是非常高的。